原文:Where’re All The AI Chips? 原作者:Ed Zitron · Where’s Your Ed At · 2026-09-22 中文翻译;版权归原作者所有。
几个月前,我曾发问数据中心都去哪儿了,因为尽管资本支出巨大、工程不断推进,且内存成本飞涨,但我很难找到证据证明有大量数据中心真正完工。
这个问题的答案实际上是「哪里都没有」。除了专门为 OpenAI 建设的巨型「Fairwater」数据中心(所谓「开放」也只是部分建筑通电投入使用,其余部分要么正在积极施工,要么预计在未来某个时间开工)之外,我能查到的大多数微软(Microsoft)数据中心项目几乎都才刚刚动工。
几个月后,《卫报》(The Guardian)与我合作展开了一项调查,我们通过一位熟悉微软 GPU 算力容量的消息人士得知,微软大约拥有 220 万块芯片。当时,我无法核实这些是否是其 全部 GPU,也无法确认 OpenAI 是否拥有不包含在我们获取的数据中的独立配额,因此我当时略去了一项报道内容——根据投入运行的 GPU 具体配置推算,微软拥有约 1.993 吉瓦(GW)的容量,背后是由价值约 500 亿美元的 GPU 支撑,主要是英伟达(NVIDIA)H100 和 H200 芯片,外加相当数量的 GB200 和 GB300。
两周前,彭博社(Bloomberg)报道称,微软拥有「约 12 吉瓦的容量」,但「……该公司目前 12 吉瓦的容量中,只有约 2 吉瓦是专门用于 AI 芯片的。」报道随后引用了一句话:
基础设施专家阿里斯泰尔·斯皮尔斯(Alistair Speirs)表示,新型 AI 工具除了使用 GPU 外,还在使用越来越多的 CPU 服务器,这意味着微软需要扩展所有类型的算力,「光靠 GPU 本身并不能构成优秀的 AI 基础设施。」
这其实是一种非常委婉的说法,意在指出微软在容量问题上直接误导了记者、投资者和公众。在过去近一年的时间里,微软一再声称自己上线了 数吉瓦的容量,在我看来,这完全是为了粉饰 AI 数据中心建设的真实规模。而我认为,借用萨提亚·纳德拉(Satya Nadella)的话来说,大部分 GPU 目前不过是「堆在库存里(他们)根本插不上电」。
今天的这期通讯讨论的是一个残酷的真相:英伟达的收入增长,几乎完全源于超大规模云厂商和新型云服务商的投机性采购,而安装这些 GPU 需要花费数年时间。
换句话说,我认为所有人都完全误判了数据中心的容量,一旦他们理清真相,这将是一场难以收拾的噩梦。
所有人都希望 AI 就像当年的互联网泡沫一样,而我担心这些 GPU 最终可能会沦落为像在新墨西哥州被掩埋的数百万盘未售出的雅达利(Atari)《E.T.》卡带一样的下场。
微软仅拥有 2 吉瓦专用于 AI 的数据中心容量,尽管它声称连续三个季度每季度新增 1 吉瓦
2025 年 9 月,首席执行官萨提亚·纳德拉声称微软在「过去一年中」增加了 2 吉瓦的容量,并表现得好像 Fairwater(一个包含两处正在积极建设的数据中心的项目,其中威斯康星州项目于 2023 年 9 月动工,亚特兰大项目于 2024 年 7 月动工)是一项值得「宣布」的重大成果,而不是「一个耗时极长、成本极其昂贵的项目」。纳德拉还声称「有多个完全相同的 Fairwater 数据中心正在建设中」,尽管他并未具体点名是哪些。
在 2026 财年第二季度、第三季度和第四季度的财报电话会议上,微软使用了几乎如出一辙的措辞:
- 萨提亚·纳德拉,2026 财年 Q2(2026 年 1 月 28 日)财报电话会议: 总的来说,仅在本季度我们就增加了近 1 吉瓦的总容量。
- 萨提亚·纳德拉,2026 财年 Q3(2026 年 4 月 29 日)财报电话会议: 总的来说,我们本季度又增加了 1 吉瓦的容量,并有望在短短两年内将我们的总体业务版图扩大一倍。
- 萨提亚·纳德拉,2026 财年 Q4(2026 年 7 月 29 日)财报电话会议: 总的来说,我们本季度又增加了 1 吉瓦的容量,并有望在短短两年内将我们的总容量大约翻一番。
虽然我无法确知发表这些言论的确切意图,但我找不到任何其他解释,只能将其视为一种欺骗行为。
在 2026 财年第二季度财报电话会议上,微软首席财务官艾米·胡德(Amy Hood)在回答瑞银(UBS)分析师卡尔·克斯泰德(Karl Keirstead)的提问时,再次重复了「吉瓦」这一说法(粗体为作者所加):
卡尔·克斯泰德,瑞银:好的,非常感谢。
萨提亚和艾米,无论你们如何在第一方和第三方之间分配容量,能否从定性角度谈谈即将上线的容量规模?我认为 12 月所在季度新增的 1 吉瓦容量是非同寻常的,这表明容量扩张正在加速,但我认为许多投资者都在关注亚特兰大 Fairwater 和威斯康星 Fairwater,希望了解有关未来几个季度新增容量规模的评价,无论它们如何分配。谢谢。
艾米·胡德:好的,卡尔,我想我们已经谈过几点了。我们正在竭尽全力以最快速度增加容量。你提到了像亚特兰大或威斯康星这样的具体地点。这些都是跨越数年的交付项目,所以我不会把注意力仅仅局限在具体地点上。
我们真正要做的事情,也是我们正在付出极大努力推进的事情,是在全球范围内增加容量。其中很大一部分将部署在美国,也就是你提到的那两个地点,但同时也需要在全球范围内扩张,以满足我们所看到的客户需求和使用量的增长。
我们将继续增加长周期基础设施。对此的理解方式是,我们需要确保拥有可用的电力、土地和设施,一旦这些设施建成,我们将以最快的速度继续向其中部署 GPU 和 CPU。最后,我们将努力确保在推进速度和运营方式上实现尽可能高的效率,以便它们能够发挥出最大的效用。
请注意,卡尔的提问直接针对的是亚特兰大和威斯康星的 Fairwater 项目,这两个项目都是专门为 OpenAI 设立的明确以 AI 为重点的数据中心,而胡德在回答时提到了 12 月所在季度的 1 吉瓦容量(指的是 2026 财年 Q1,而当时并未提及在单一季度内增加了 1 吉瓦)。
我完全可以预料到有人会回应说微软这里的表述在「法律层面上」合规,因为他们从未说过这是 AI 容量,但任何这样辩解的人都抱有一种认知低下的心态。任何阅读这份电话会议记录或听到微软提及增加「数吉瓦」数据中心容量的人,都会自然而然地联想到 AI 数据中心容量——正如这篇文章和这篇文章所体现的,以及基本上所有谈论这个话题的人所理解的那样。
让我直截了当地说:自 2022 年初以来,微软似乎花费了约 2650 亿美元的资本支出(并在其物业、厂房和设备中增加了约 3200 亿美元的资产),却仅让大约价值 500 亿美元的 GPU 投入运行,并利用宽泛而模糊的措辞让自己看起来高效得多。
天底下没有任何人坐在这里琢磨微软是否增加了数吉瓦的 CPU 容量 或 云存储,分析师们也并非迫切想要听到汇总数据——他们问的是你们花在 AI 上的所有资金究竟流向了何处,而答案似乎是「进了仓库」或「进了尚未通电的数据中心」。
为了进一步说明这一点,我分析了微软从 2010 财年至 2022 财年的财报电话会议,发现在与亚马逊网络服务(AWS)和谷歌云(Google Cloud)的竞争之外,几乎没有关于数据中心容量的讨论,更没有任何关于兆瓦(MW)或吉瓦的讨论。在财报电话会议中,微软对兆瓦和吉瓦的使用完全是 AI 时代的术语,首次出现是在其 2025 财年 Q4 财报电话会议上,尽管它曾在其他场合使用过,例如在《商业内幕》(Business Insider)于 2024 年 4 月报道的一份文件中,微软表示已经上线了「超过 500 兆瓦的新数据中心容量」,其中包括这句发人深省的话(粗体为作者所加):
文件称,在去年下半年,微软交付了「创纪录水平的 GPU 容量」,将其安装的 GPU 总基数翻了一倍多,但未提及具体数字。
微软在数据上含糊其辞,似乎是为了掩盖一个显而易见的真相:他们正斥资数千亿美元购买 GPU,而这些芯片却存放在仓库或未通电的数据中心里,可能要提前数年闲置。
这是一起巨大的丑闻。如果微软没有地方放置这些 GPU,为什么还要买这么多?为什么不等需要的时候再买,而是提前数月甚至数年采购?当微软显然没有兑现时,为什么还要告诉我们它正在上线数吉瓦的容量?
到了这个地步,我们还能把 任何一家公司 的容量公告当真吗?
微软据估计囤积了价值 500 亿至 1000 亿美元的 GPU
微软是最早构建由 GPU 驱动的 AI 数据中心的公司之一(早在 2020 年,专门为 OpenAI 构建),在搭建计算基础设施方面拥有极其丰富的经验和资源。
我必须强调这一点,因为除了超大规模云厂商之外,其他建设大型数据中心的公司要么是新型云服务商(其中许多是前加密货币挖矿公司),要么是甲骨文(Oracle,其在 2016 年才涉足云基础设施,远晚于微软推出 Azure 和谷歌推出谷歌云)。
如果说 有谁 拥有大规模部署大型 AI 基础设施资产的专业知识和资源,那就是微软——因此,微软在部署 AI 基础设施方面的成效,比新型云服务商甚至甲骨文的表现更具参考意义。
正如我上面所提到的,截至几个月前,微软实际投入使用的 GPU 价值约为 500 亿美元,对应估计约 1.993 吉瓦的 AI 容量,而彭博社在 2026 年 9 月 11 日报道称其拥有「大约」2 吉瓦。
微软已经花费了 2650 亿美元的资本支出,根据富国银行(Wells Fargo)的迈克尔·图林(Michael Turrin)和瑞穗证券(Mizuho Securities)的格雷格·莫斯科维茨(Gregg Moskowitz)的估计,以及微软自身在财报电话会议上的声明:
- 在 2025 财年(2024 年 7 月 1 日至 2025 年 6 月 30 日,总资本支出为 646 亿美元),微软在短寿命资产(即:GPU 和相关设备)与长寿命资产(即:建筑物等物理基础设施)之间的比例为 50/50,这意味着大约 323 亿美元用于 GPU 和相关设备。
- 在 2026 财年(2025 年 7 月 1 日至 2026 年 6 月 30 日,总资本支出为 1159 亿美元),微软的比例为三分之二(67%)用于短寿命资产,即 约 744 亿美元用于 GPU 和相关设备。
- 这给我们留下了估计 1067 亿美元尚未安装的短寿命 GPU。
- 我承认可能存在 其他 短寿命资产,但微软在财报电话会议上的用词指出它们「主要指 CPU 和 GPU」。
- 我严重怀疑微软在 CPU 上的花费会超过几十亿美元。
- 我预先假设这是 AI 看多派首先会抓住的辩解点,但我想明确说明,确实没有其他高价值大宗项目能够占用如此多的资本支出。
如前所述,纳德拉在 2025 年 11 月提到,他有「……一堆芯片堆在库存里(他插不上电)」,但没有提及具体有多少。
换句话说,微软在仓库里积压了价值 500 亿至 1000 亿美元的 GPU,而在过去四年中,真正完成安装的价值刚过 500 亿美元。
如果连微软都在苦苦挣扎,那么 所有人 都在苦苦挣扎,我们可能会面对一个非常令人不安的真相:英伟达可能已经提前数年卖出了价值数千亿美元的 GPU。
是的,所有人 都在苦苦挣扎。
新型云服务商和超大规模厂商拥有超过 3740 亿美元的「在建工程」资产,估计有超过 2000 亿美元的 GPU 闲置在仓库中
微软作为一家极度缺乏透明度且具有误导性的公司,并未在其资产负债表上披露其「在建工程」(Construction In Progress, CIP)——这是企业记录所有正在建设的项目的地方,在 AI 时代,这里记录着尚未建成的数据中心和尚未安装的 GPU(或者对于谷歌而言,则是其定制的 TPU AI 芯片)。
旁注: 在建工程是一项 存量 而非 累计总额——资本支出代表花掉了多少钱,而 CIP 代表着 物资 的堆积。
在包括谷歌、Meta、甲骨文、亚马逊、SpaceX 和特斯拉在内的超大规模厂商,像 CoreWeave 和 IREN 这样的新型云服务商,以及像 Core Scientific 和 Applied Digital 这样的主机托管公司中,在建工程规模已超过 3740 亿美元,这个数字可能 低于 真实数字,因为亚马逊的数据(717 亿美元)仅更新至 2025 年底。
这 3740 亿美元的数字不包括来自微软、Firmus、Sharon AI、Equinix、Nebius 或 Vantage、DataBank、CyrusOne、QTS 等众多非公开运营商的任何 CIP。它不包括任何主权 AI 项目(Humain/沙特阿美、新加坡、印度信实工业、阿联酋的 G42),不包括由 OpenAI 或 Anthropic 运营或为其设立的私有项目,不包括 Stack Infrastructure(该公司正在为甲骨文建设新墨西哥州数据中心,由于甲骨文不「拥有」该项目,其 CIP 并未计入甲骨文的资产负债表),也不包括 Meta 价值 273 亿美元的表外「Hyperion」数据中心。在这些项目之间,我认为至少还有 500 亿至 1000 亿美元的 CIP,但为了公允起见,我并未将其计入总额中。
在整个数据集中,该数字已从 2023 年的 1029 亿美元增加到 2024 年的 1456 亿美元,再到 2025 年的 2432 亿美元。
在 2023 年至 2025 年间,这些公司的资本支出总计为 3516 亿美元,对应 2432 亿美元的 CIP。换句话说,大量的资金流出,换来的是一堆庞大、混乱且可能毫无产出的物资积压。
坦白讲,我认为 2000 亿美元这个估算可能还算保守了。
考虑到甲骨文在最新季度财报中的 CIP 数据为 485 亿美元,而谷歌 2026 年第二季度的「尚未投入使用的资产」达到惊人的 1228 亿美元(高于 2026 年第一季度的 1085 亿美元和 2025 年底的 785 亿美元),有理由相信微软 至少 拥有 500 亿美元的在建工程。我还认为可以合理推测,亚马逊自 2026 年初以来至少向 CIP 增加了 250 亿美元,不过我们要在年底才能确切知晓。
就资产构成而言,我认为假设 50/50 的比例是合理的。在谷歌最新的财报电话会议上,首席财务官阿纳特·阿什肯纳齐(Anat Ashkenazi)表示「……本季度我们在技术基础设施方面的投资有 60% 用于服务器」,指的是配备 GPU 或 TPU 的服务器。富国银行的肯·加夫雷尔斯基(Ken Gawrelski)在 2026 年 1 月的一份报告中估计,Meta 约 65% 的资本支出与「寿命较短的服务器和网络设备资产」挂钩。瑞银的卡尔·克斯泰德在 2026 年 1 月的一份报告中指出,「……甲骨文绝大部分资本支出用于设备,主要是英伟达 GPU」,并补充道,「……相比之下,我们估计微软未来 5 年的年均资本支出中,可能有 60% 即约 1250 亿美元用于短寿命设备/芯片。」
然而,可以说是最具启发性的一句话来自亚马逊首席执行官安迪·贾西(Andy Jassy)在 4 月份召开的 2026 年 Q1 财报电话会议上:
……AWS 必须提前为土地、电力、建筑物、芯片、服务器和网络设备支付现金,然后才能实现商业化变现,根据组件的不同,通常要在我们开始向客户收费前 6 到 24 个月投入。
因此,如果我们假设该基数为大约 3740 亿美元,加上微软的(至少)500 亿美元,再加上亚马逊的(至少)200 亿美元,总额就来到了大约 4440 亿美元,其中谷歌的份额——1208 亿美元——有 60% 为 GPU 和相关硬件,即 724.8 亿美元。按此计算(假设按 50/50 拆分),估计有价值 2340 亿美元的 GPU 和 TPU 闲置在仓库中。
自 2023 年初以来,英伟达和博通共售出了约 5615 亿美元的 AI 芯片和硬件,这意味着约 50% 售出的 AI 芯片/硬件被囤积在仓库中,其销售额是投机而非价值创造的产物
自 2023 日历年年初以来,英伟达售出了约 4964 亿美元的 GPU 和相关设备,博通(Broadcom)售出了约 651 亿美元的 AI 芯片(不过需要补充的是,博通直到 2024 年 3 月财报才开始披露其 AI 业务部门),总计达 5615 亿美元。
旁注: 除非另有说明,我在此均采用日历年,因为这是贯穿我的分析以匹配 CIP 的最佳方式。
根据与熟悉 Azure 基础设施的消息人士沟通,微软有大量投入运行的 H100 和 H200 库存——主要由数十万块 Hopper 芯片组成,在沟通时还拥有大约 16 万块 Blackwell GPU。
根据对英伟达在此期间财报电话会议的深入分析,结合瑞穗证券的维杰·拉凯什(Vijay Rakesh)和德意志银行(Deutsche Bank)的罗斯·西摩(Ross Seymore)的估计,我 粗略 估计英伟达已售出约 2226 亿美元的 Hopper GPU 和 2709 亿美元的 Blackwell GPU。我认为有理由相信,绝大多数(如果不是全部的话)Hopper GPU 已经安装完毕,剩下数百万块 Blackwell GPU 正等待安装。
需要明确的是,这是我在 2025 年 11 月提出的主张,当时我字面理解了黄仁勋(Jensen Huang)关于英伟达出货了「600 万块」英伟达 GPU 的声明,而没有采用黄仁勋那种「每块 GPU 实际上等于两块 GPU」的古怪数学逻辑将总量折算为 300 万块。
尽管如此,基于我今天讨论的所有内容,完全有理由质疑 这些 Blackwell GPU 中是否有哪怕四分之一真正进入了数据中心,或者至少是 接入了电力的数据中心。
如果事实(而且目前看来极有可能)是英伟达提前数年售出了 数千亿美元的 GPU,这将从根本上改变关于 AI 泡沫和 AI 数据中心建设的一切叙事。
所有的 AI 数据中心容量数据目前都显得可疑、成疑,或者完全无法作为衡量实际运行情况的晴雨表
我偶尔会引用 Sightline Climate 2 月份的预测数据,在此我完整引用其内容:
我们正在追踪自 2024 年以来宣布的 777 个大型数据中心和 AI 工厂(>50MW),涉及容量达 190 吉瓦。大约 140 个项目中至少有 16 吉瓦的容量预计将于 2026 年上线。然而,目前仅有约 5 吉瓦在建。尽管通常的建设周期为 12 至 18 个月,但仍有约 11 吉瓦处于已宣布但未见明显施工进展的阶段。
我非常欣赏 Sightline Climate,并认为他们做出了重要且有益的工作,但基于微软对「容量」真正含义的混淆,我认为几乎所有关于 已投入运营 的 AI 数据中心容量的估计在实际层面上都已经失去参考价值。 虽然我们可以将 Sightline 的数据作为衡量 规划中有多少 的指标,但我不再认为有任何人真正掌握了 已建成了 多少容量。
对于任何企业发布的关于其潜在容量的声明或相关报道,只要没有将活跃的 AI 容量与整体容量明确区分开来,结论同样适用。
AI 数据中心容量的文字游戏
据报道,微软声称其拥有 12 吉瓦的容量——其中 3 吉瓦是在过去三个季度内上线的!——但其中只有 2 吉瓦属于 AI 数据中心容量,这引出了两个疑问:
- 我们讨论的是 电力容量 还是 IT 负载?
- 如果是电力容量,这个数字在实际层面毫无意义。
- 这是 实际的数据中心容量 还是 已锁定的总电力?
- 如果是后者,微软实际上是在说「我从别人那里拿到了电力指标」,而不是「我拥有一个接入了电力、由我自己建造或委托建造的数据中心」。
- 如果在九个月内上线了 3 吉瓦的容量,而 AI 容量充其量只增加了几百兆瓦,那么其他数据中心里装的到底是什么东西?
- 我实在无法理解微软是如何做到总容量达到 12 吉瓦,而 AI 数据中心容量却只有 2 吉瓦的。
很显然,微软在「容量」这一术语上玩弄花招,这让我相信这是整个行业普遍存在的问题。
CoreWeave
例如,CoreWeave 在最新的财报演示中声称,上一季度增加了 850 兆瓦的「活跃电力」:
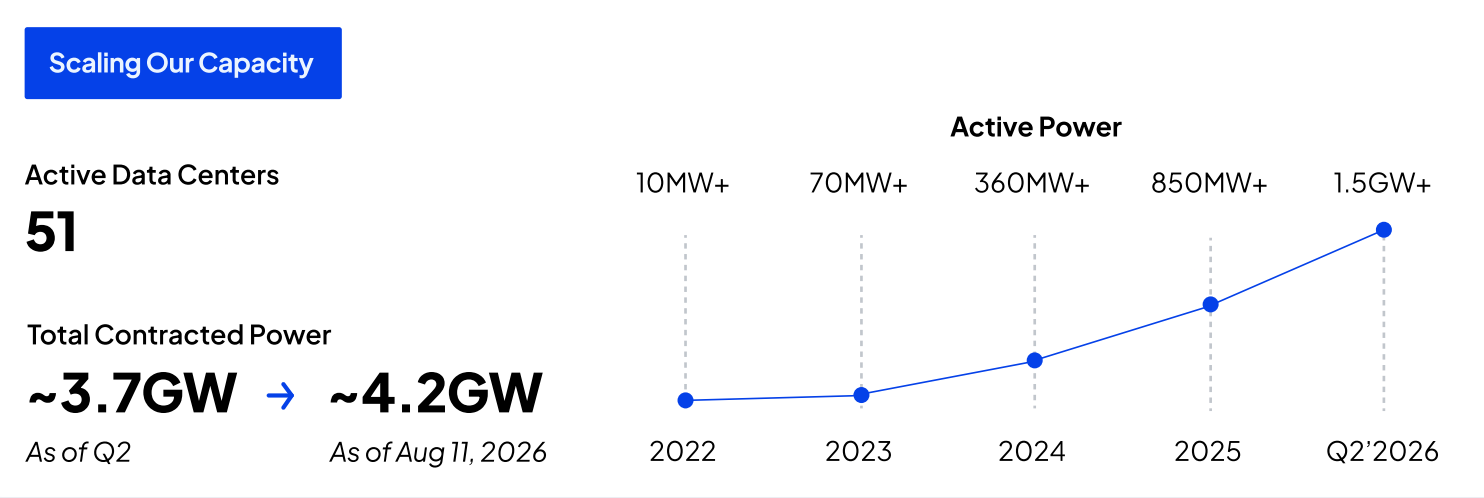
这究竟是 活跃且产生收入的 AI 数据中心容量,还是 某个发电厂因数据中心尚未建成而未接入任何设备的 850 兆瓦电力,两者之间存在巨大差异;正如它如果 仅仅代表 50 兆瓦或 200 兆瓦的 AI 数据中心容量,情况也会截然不同。
甲骨文
就甲骨文而言,联席首席执行官克莱·马古伊克(Clay Magouyrk)在最近的财报电话会议上发表的一些言论同样具有误导性:
好的。谢谢,迈克。OCI 继续通过交付客户所需的容量实现快速增长。自第四季度结束以来,我们向客户交付了包含超过 30 万块 GPU 的 850 兆瓦 AI 容量。第一季度的交付量几乎是整个第四季度交付量的 3 倍,占上一财年交付总容量的 73%。这反映了我们在基础设施各个方面多年的投资,从数据中心设计、供应链和制造,到安装和运营。
为了明确起见,以下是马古伊克先生陈述的要点:
- 自第四季度(截至 2026 年 5 月 31 日的 2026 财年)结束以来,甲骨文交付了 850 兆瓦的 AI 容量,包含「超过 30 万块(未指明型号的)GPU」。
- 2027 财年第一季度的交付量是「上一财年交付总容量的 73%」,这 可能 意味着 620 兆瓦的 AI 数据中心 容量,但他用的是 总容量,其中包含了 非 AI 数据中心。
随后还有另一段关于 Stargate Abilene 的话让我 非常困惑。这是一个总容量为 1.2 吉瓦/IT 负载为 824 兆瓦(即:GPU 和关键硬件)的数据中心园区,自 2024 年 6 月以来一直在建设中。
亚比林(Abilene)项目继续以非凡的速度交付。我们在第一季度在那里交付了 13.1 万块 GPU,是第四季度交付量的 1.9 倍。该园区的 8 栋建筑中已有 6 栋交付给客户,代表着 618 兆瓦和总容量的 75%。客户验收时间已缩短至仅 24 小时,这表明系统运抵时已完全准备好承载客户的工作负载。最新发布的 GPT-6 Astra 就是在我们位于亚比林的基地完成训练的。
我正在等待消息人士的更新,但截至今年 6 月,亚比林只有三栋建筑准备就绪,第四栋始终处于在建状态。我承认建设可能已经加速,但根据 Yes Energy 的分析,截至 6 月,Stargate Abilene 的 总 耗电负荷约为 450 兆瓦——而马古伊克先生明确提到了「总容量的 75%」和「618 兆瓦」,这听起来指的像是 IT 负载。
对于这里究竟发生了什么,我甚至无法给出一个明确的答案,只能说我们对于到底建成了多少数据中心容量缺乏足够的透明度(甚至毫无透明度)。
亚马逊
我们在全球范围内增加的数据中心容量超过任何其他公司,仅在第四季度(2025 年)就增加了超过 1.2 吉瓦(GW),我们预计 AI 和云服务将继续增长。在扩张的同时,我们持续致力于提高效率。
你读到这段话时理应会惊叹「哇,1.2 吉瓦的 AI 数据中心容量」,但正如我们在微软身上看到的那样,这根本 不代表任何类似的意思。
《数据中心动态》(Data Center Dynamics)在针对该报告的报道中无意中道破了玄机:
至于亚马逊的竞争对手,确切数字同样未予披露。微软在其所谓的 2026 财年第二季度建成了 1 吉瓦的数据中心容量,但这实际上与亚马逊的第四季度处于同一时间段。在其 2025 财年,微软总共上线了 2 吉瓦的容量。
正如我们已经证实的,那「1 吉瓦的容量」绝不意味着 1 吉瓦的 AI 数据中心容量,甚至不代表 任何形式的可用容量。 事实上,究竟增加了什么完全不得而知,因为这些公司谁也不会告诉你。
OpenAI
在 2025 年底,OpenAI 声称自己拥有「1.9 吉瓦的算力」——这表明它占用了微软的绝大部分基础设施和甲骨文的部分基础设施——但它并没有说明这是 活跃电力、IT 负载,还是 该公司甚至能够实际调用的算力。
基于目前的资本支出,超大规模厂商的折旧数据完全不合常理
正如我几个月前所讨论的,尽管资本支出数额庞大,但超大规模厂商的折旧情况——我指的是从 GPU 投入使用开始将其成本分摊到 6 年的时间里——同样表明绝大多数资本支出尚未投入使用。
为了说明这一点,我调取了超大规模厂商折旧与摊销(D&A)占资本支出比例的历史图表。如果资本支出能够迅速转化为运营中、实用且产生收入的资产,那么该比例应该不断增长,而不是逐季暴跌。谷歌的这一比例处于令人尴尬的 15.8%,这意味着每 1 美元的资本支出中只有不到 16 美分计入折旧与摊销。虽然这不是一项 即时现金支出(因为它是在一段时间内分摊某项资产的成本),但它会侵蚀净利润。
正如你将看到的,超大规模厂商多次重新调整服务器的「使用寿命」,使他们能够将包含 AI GPU 的服务器成本多摊销一到两年,从而降低折旧成本。
例如,在 2022 年,微软将服务器的使用寿命从四年延长到六年——而在今年,将实际数据中心结构的折旧年限从 15 年延长至 25 年。次年,Meta 和谷歌也纷纷效仿,Meta 将使用寿命延长至五年,谷歌延长至六年。Meta 在 2025 年再次延长了其服务器的使用寿命,推迟至 5.5 年。
与此同时,亚马逊在服务器寿命问题上反复无常,在过去六年中多次延长(和缩短)。援引 MoneyWise 的说法:
折旧是这一切背后的核心机制——即企业将设备成本分摊到预期使用年限中的方式。拉长这一假设,眼下的利润就会更好看。缩短它,账单就会更快到来。
亚马逊反复进行了这两种操作。服务器寿命在 2020 年从三年调整为四年,2022 年从四年调整为五年,2024 年 1 月从五年调整为六年,随后在 2025 年又逆转(恢复为五年)。
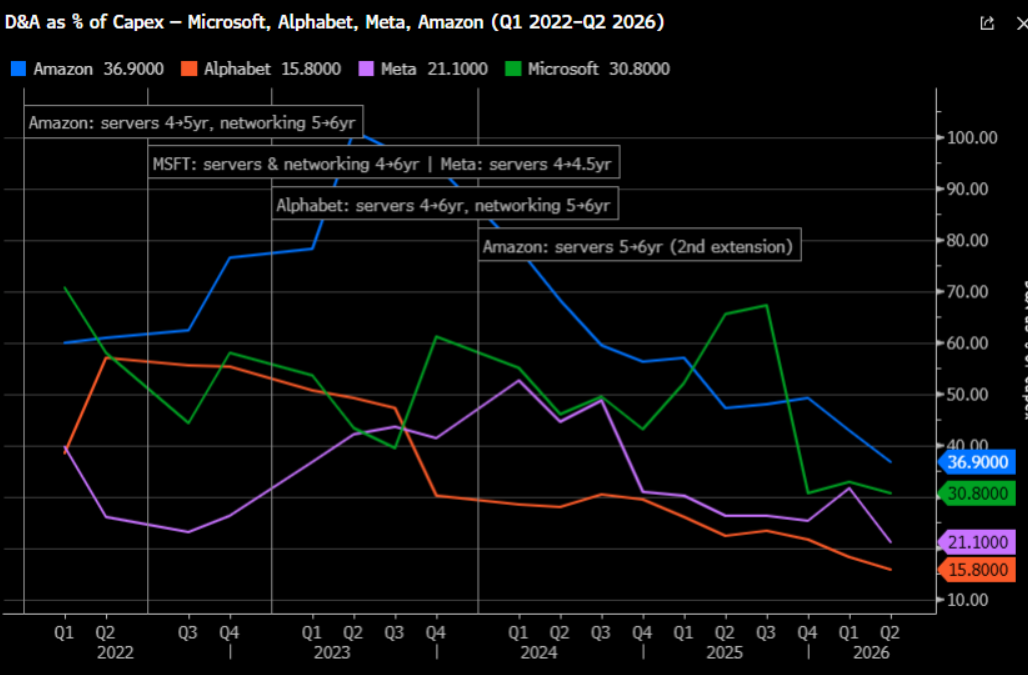
这张图表告诉我们三件事:
- 超大规模厂商将资本支出转化为运营容量的能力正变得越来越差。
- 超大规模厂商未来将面临巨额的折旧费用,这将严重吞噬他们的利润。
- 超大规模厂商存在严重的过度支出问题。
由于他们对其真实容量或资本支出的实际流向持续遮遮掩掩,折旧何时会大幅激增谁也说不准。
但它终究会在某个时刻爆发,除非他们打算直接对这些 GPU 进行资产减记。
英伟达提前数年售出了价值数千亿美元的 GPU——为什么各家公司还在继续买?
这种情况极其荒谬。
非常明显的是,英伟达至少 2000 亿美元(甚至可能超过 3000 亿美元)的 GPU 销售额是提前一年或数年达成的,而与此同时,该公司对外宣称其在 2028 财年(始于 2027 年 2 月)的收入将超过 6700 亿美元。
同样显而易见的是,微软、谷歌、亚马逊、Meta、SpaceX 以及所有新型云服务商都在以每次数百亿美元的规模采购英伟达 GPU,而他们心知肚明的是,建设容纳这些芯片的容量并接通电力需要花费数年时间。这不仅构成了资本主义历史上最大规模的预售活动,而且 严重歪曲了当前 AI 基础设施建设的真实进展。
超大规模厂商超过 1.2 万亿美元的资本支出中,转化为可运营数据中心容量的不足 50%——导致估计有超过 3900 亿美元的 AI 硬件处于未安装状态
投资者和记者一直以为,每个季度都有数吉瓦的 AI 数据中心容量 正常上线,英伟达赚取了数千亿美元,其售出的 GPU 也被迅速部署到 AI 基础设施中。
自 2022 年初以来,亚马逊、谷歌、微软和 Meta 的资本支出总和已超过 1 万亿美元。如果微软能够代表行业整体水平——即约 18%(约 500 亿美元)的资本支出转化为能够产生收入的 IT 基础设施——这意味着在四大超大规模厂商中,只有大约 2226.6 亿美元的英伟达及其他 AI 芯片真正在运行并发挥效用。
旁注: 我知道亚马逊在 AI 数据中心之外,还有与其电子商务和物流业务相关的资本支出,但鉴于其自 2022 年以来的快速增长,我认为其中大部分归因于 AI。以下估算虽不完美,但我认为有充分的依据。
如果我们保守假设数据中心成本的 50% 用于施工建设,这意味着大约有价值 4453 亿美元的数据中心容量已投入运营。
这留下了大约 7910 亿美元去向不明的资本支出,这是相当灾难性的局面。如果我们假设 其中 的 50% 用于购买 GPU(涵盖英伟达、AMD、Trainium、TPU 及其他任何定制芯片),那就意味着大约有价值 3950 亿美元的芯片虽然已经售出,但(但愿)正堆在仓库或未通电的数据中心里;如果这些芯片只是停留在账面上的销售,那在会计合规性上就……大有问题了。我愿意相信其中一部分也属于 CPU 基础设施、存储以及未直接流向英伟达的其他支出。
无论如何,这都是数量极其庞大且尚未部署的芯片,这与英伟达和超大规模厂商向投资者描绘的景象有着天壤之别。
「我们正在购买大量 GPU 并建造大量数据中心来赚取巨额利润」与「我们投资这些东西是押注它们在未来数年可能为我们赚钱的微茫机会」之间,存在着本质区别。
我来剖析一下:
- 如果投资者和公众相信微软、谷歌、亚马逊和 Meta 正在迅速上线容量,那么他们当前的资本支出速度就是合理的,因为这被视为 通过花钱 来 赚钱。
- 如果事实是这些资本支出的绝大部分都流进了 黄仁勋的腰包并塞满了装满 GPU 的仓库,这意味着投资者在收入增长前景方面被兜售了一套谎言。
如果大部分「AI 押注」根本还没摆上台面,就谈不上谁的「AI 押注获得了回报」
在大多数情况下,超大规模厂商的资本支出之所以能得到市场的 认可,是因为它们的整体收入实现了增长,所有人都高呼他们的「AI 押注 获得 了 回报」,而事实表明,所谓的 AI 押注才刚刚开始进入上线阶段。
我认为,谷歌、亚马逊、微软以及 最值得注意的 非 Meta 公司 在 AI 时代实现显著收入增长的原因在于,它们实际上将所有可用的算力都卖给了 Anthropic 或 OpenAI,这两家公司占到了其 AI 收入的 70% 以上;这也是为什么唯一实现收入增长的 AI 数据中心公司(CoreWeave、Nebius、IREN 等)都直接或间接地与这两家 AI 实验室挂钩。
得益于注入给 OpenAI 和 Anthropic 的近乎无限的资金(仅 2026 年就超过 2170 亿美元),超大规模厂商能够完全填满其上线的任何 GPU 基础设施,因为这两家 AI 实验室弹药充足,并且愿意买下市面上几乎所有的可用算力。
正因为其他方面的容量上线 极为缓慢,这释放出了一个关于 AI 算力「需求永不满足」的虚假信号,而 真实 情况是,几乎没有任何算力真正上线,即使是由全球规模最大、资金最雄厚的企业建设的算力也是如此。
超过 2000 亿美元未安装的 GPU 坐实了我们正处于产能过剩局面——以及 Anthropic 和 OpenAI 如何扭曲了对 AI 算力的需求
我举个例子。自 2022 年初以来,微软在资本支出上花费了 2650 亿美元,而在其最近一个财年中,其 70% 的 AI 收入(以及其总收入的 7%)来自 OpenAI。如果你作为投资者认为这笔收入是 所有这些资本支出 带来的成果,那你就大错特错了。事实上,大部分资本支出根本还没有投入实际运转。
亚马逊、谷歌和微软多次表示,它们面临着远远超出容量的需求,但对于这些需求来自何处却讳莫如深,很大程度上是因为答案就是 OpenAI、Anthropic,或者对于 谷歌 和 微软 来说,还有 Meta。 如果我觉得自己解释得太繁琐,我深表歉意,但我真的需要把这个问题的症结讲透彻。
如果是由于数百万客户对 AI 算力的渴求而导致「需求超出供给」,这与因为 三家客户吃掉了绝大部分或全部容量 而导致的「需求超出供给」是截然不同的。
同样,如果是 因为大量容量上线且有广泛多元的客户群在购买 而导致的「需求超出供给」,这与 容量上线缓慢,且绝大部分被直接交给 OpenAI、Anthropic 或 Meta 的情况相比,更是 天差地别。
来自 Anthropic 和 OpenAI 的 1.3 万亿美元算力承诺造成了对 AI 算力需求的扭曲,部分源于其庞大的资金规模,部分源于其对算力异想天开的需求。
谷歌、微软、亚马逊、CoreWeave、IREN、Nebius 和 Nscale 积累的庞大待交付订单,并非源自 对 AI 算力的真实强劲需求,而是源自 Anthropic 和 OpenAI 签署合同的惊人手笔。例如,Nscale 与 Anthropic 达成的 450 亿美元交易以及与微软的一份合同占到了其 1030 亿美元待交付订单的 85%,而 Anthropic 的这笔交易还取决于尚未募集到位的资金。这些待交付订单经常被用来证明大规模 AI 数据中心建设的合理性,而它们本质上不过是达里奥·阿莫代伊(Dario Amodei)和萨姆·奥特曼(Sam Altman)在 DocuSign 账户上签下的数字。
你看,根本问题在于,由于数据中心容量信息的模糊不清,超大规模厂商之外的世界一直误以为这些公司是在 购买 GPU 并 迅速将其转化为现金,而现实却是 购买这些 GPU 并迅速将其堆进仓库。
顺便说一句,这就是超大规模厂商不单独明确拆分其 AI 收入所带来的弊端,因为通过这种做法,他们制造了一种(我认为是刻意为之的)假象,即 AI 资本支出 正在推动 收入增长,这既诱骗了投资者购买他们的股票,也误导了开发商盲目建设 AI 数据中心,误以为资本支出能够迅速转化为收入。
你可以嘲笑投资者或开发商应该「做更充分的研究」或「去深入了解情况」,但请记住,关于数据中心建设的绝大多数数据点要么具有误导性,要么纯属天方夜谭。我曾见过关于 2026 年将有 12 吉瓦、15 吉瓦乃至多达 20 吉瓦容量上线的预测,但基于我今天讨论的所有内容,我认为相信 实际存在超过 5 到 10 吉瓦已投入运营的 AI 数据中心容量 是极其可笑的。
旁注: 根据彭博行业研究(Bloomberg Intelligence)的昆詹·索巴尼(Kunjan Sobhani)和奥斯卡·埃尔南德斯·特哈达(Oscar Hernandez Tejada)的数据,截至 2026 年 3 月 2 日,有「大约」9 吉瓦的 AI 数据中心容量「已上线并基本被消化」,但即便如此,我也怀疑这个数字指的是总容量,而不是上述数据中心的关键 IT 负载。
当微软和亚马逊这样的公司每个季度都在声称自己正在上线 1 吉瓦的容量——其措辞方式让你 误以为 这是 AI 数据中心容量——你该相信什么?难道你该相信全球最大的这些公司会为了让自己的资本支出显得更有效率而主动误导你吗?
反过来,难道你该相信每一家大肆宣扬每年有数以吉瓦计的理论容量上线的媒体机构和研究公司全都搞错了吗?
不,你大概率会选择相信市场共识,即使底层的数字根本站不住脚,即使微软宣布的容量似乎从未真正上线;因为如果你 不 相信共识,你就必须承认所有人都搞错了。
如果……我们正处于 AI 数据中心的产能过剩中呢?
因此,在进一步讨论之前,让我先说明几点:
- 就目前来看,从我能看到的每一个信息源推断,建设一座 AI 数据中心似乎需要耗费数年时间。
- 价值数千亿美元的 GPU 是在预期这些容量将被建成、通电并出租给某人的前提下提前售出的。
- 眼下,容量的实际交付极其缓慢,而没有人愿意真正谈论这一点。
你还会注意到,市面上充斥着 海量 关于 宣布启动 的 AI 数据中心的新闻,但 关于竣工项目的报道却少之又少,而这些少数报道大多只是在进行形象粉饰。
例如,CNBC 帮着甲骨文和亚马逊玩了同样的把戏,声称它们的数据中心已经「开放」,而实际上它们只是 开放了数据中心园区众多组成部分中的一个或少数几个:
- 2025 年 9 月 23 日,记者麦肯齐·西加洛斯(MacKenzie Sigalos)报道称「OpenAI 投资 5000 亿美元的 Stargate 项目在德克萨斯州设立的首个数据中心已开放,新墨西哥州和俄亥俄州的基地即将推出」,而事实上 8 栋建筑中只有 1 栋 开放,这一事实被埋在文章的第 6 段。
- 2025 年 10 月 29 日,西加洛斯报道称「亚马逊在竞争对手争相破土动工之际,在印第安纳州农村地区开放了价值 110 亿美元的 AI 数据中心」,并声称——我引述原文——该中心「已启动并投入运营,而大多数 AI 竞争对手仍在承诺未来的数据中心」。事实上,30 栋建筑中只有 7 栋完工,这一事实被埋在文章的第 9 段和一个视频之后。
为西加洛斯说句公道话,带头搞骗局的是亚马逊,它在同日发布的一篇博文中声称 Rainier 项目「现已全面投入运营」,耍弄文字游戏将 Rainier 称为 AI 计算集群 而非 数据中心,尽管 其博文和 CNBC 报道的一切内容都是为了让你以为它指的是整个数据中心项目。
这一切都说明,在很大程度上,AI 数据中心项目随时都在被宣布并获得资金,媒体或有意或无意地配合粉饰这些项目的规模和完成度,而外部的所有人都被蒙骗,以为 AI 基础设施建设比实际情况更快、更有效。
这意味着今年发行的 2900 亿美元 AI 数据中心债务(不包括超大规模厂商)将用于以其所能达到的任何速度建设容量,这是一个严重的问题,因为绝大多数此类交易都是基于项目融资的,意味着它们依赖于一个可能存在也可能不存在的客户所产生的收入来偿还。
坦率地说,最好的情况是英伟达停止销售 GPU,或者停止发行 AI 数据中心债务,因为每当一个数据中心获得资金并破土动工,就会加剧产能过剩局面的严重性。
正如我在几个月前的深度文章《这比互联网泡沫更严重》中所讨论的,GPU 与未点亮的暗光纤完全不同。一座未完工的数据中心在 2030 年完工所需的成本与今天一样高,GPU 运行所需的成本也同样高昂。不同之处在于,一旦 AI 泡沫破裂,AI 算力的客户——主要是无法盈利、由风险投资支持的初创企业——将不复存在。
目前,在超过半数的英伟达 GPU 尚未转化为运营容量的情况下,正在建设的每一座新数据中心 本质上都是在押注 _2028 年或 2029 年的 AI 需求是否会比今天 更大 _,因为你将不得不与之前几年破土动工、随后陆续上线的全部 其他 容量展开竞争。
此外,即将到来的 Blackwell GPU 洪流也是一个难题,其中绝大多数尚未投入运营,这意味着在 2025 年购买它们的人可能会发现,当这些芯片装机完成时,恰逢第一批 Vera Rubin 芯片上线,即使届时没有出现过剩的可用容量,这也会压低价格,更不用说 未来几年还将有大量芯片集中上线。
说实话,我认为在这个节点上我们甚至还在 讨论 Vera Rubin 是有点可笑的。我们什么时候才能看到它实现规模化应用?2030 年吗?别开玩笑了。
英伟达应当就实际运营的 AI 容量与销售额发布指引,否则就是在主动误导投资者和客户
多年来,我们一直听到关于英伟达 GPU 存在「惊人需求」的故事,需要明确的是,黄仁勋赚到的钱是真金白银,无论这些 GPU 最终运往何处,英伟达确实把它们卖出去了。
然而,「我们卖出这么多 GPU 是因为人们立即安装了它们并正在赚钱」与「我们卖出这么多 GPU 是因为我们最大的客户采购了这么多,原因是他们的收入在 2022 年放缓,且已经耗尽了实现超高速增长的点子」之间,存在着巨大的鸿沟。
我知道,解释客户 为什么 购买 GPU 确实不是黄仁勋的职责,我完全赞同!
话虽如此,英伟达 确实 负有信托责任,应当披露与其销售产品相关的重大事件——例如,是否存在数百万块 GPU 实际上并未交付给客户、或者只是运进了仓库、亦或是在销售时客户 并无立即安装意图 的情况。
我想明确一点:除了供应商(英伟达)态度强硬之外,提前数月或数年购买 GPU 绝对没有任何优势或理由。 但超大规模厂商(占其收入的 50% 以上)似乎愿意季度复一季度地这样做,囤积数百亿美元来「确保供应」,而这种供应紧张完全是 由于超大规模厂商自身的抢购造成的。
尽管瑞银的蒂莫西·阿尔库里(Timothy Arcuri)在 2026 年 3 月指出客户提前大约 22 个月 下单,英伟达却唱着完全不同的调子,黄仁勋宣称「Token 即利润,算力即收入」,而他售出的大多数芯片既不产生 Token 也不产生收入,因为 这该死的数据中心建设耗时实在太长了。
我需要在这里说得更直白一些:购买了 GPU 的绝大多数公司都尚未将其转化为可观的收入,甚至根本还没有通电开机。英伟达售出的大部分产品都闲置在仓库里,这是一项英伟达本应被强制披露的重大事实。
这与 2022 年英伟达因信息披露不充分而遭到 SEC 处罚的前例并无太大不同,当时它未披露其游戏业务部门的收入增长实际上来自加密货币矿工而非游戏玩家。
虽然这里存在显而易见的不同之处——因为英伟达的客户表面上购买其数据中心 GPU 是为了放入数据中心——但这些芯片(或实际上 任何 AI 芯片)的「需求」周期,完全是由于四五家大客户大肆采购以及黄仁勋发表脱离现实的创收言论而人为制造出来的。
也许这尚未上升到引发 SEC 采取行动的程度,但 每一位记者和分析师都应该向黄仁勋以及每一位采购 GPU 的超大规模厂商高管提出以下问题:
问英伟达:
- 目前有多少 Hopper GPU 处于运营状态并正在产生收入?
- 目前有多少 Blackwell GPU 处于运营状态并正在产生收入?
- 超过 100 兆瓦的数据中心从开工到竣工(即完全通电并产生收入)需要多长时间?
- 目前有多少英伟达 GPU 处于库存状态、等待通电或虽已购买但尚未投入运营?
- 在 2025 财年和 2026 财年售出的英伟达 GPU 中,大约有多大比例已投入运营并正在产生收入?
问超大规模厂商 CEO:
- 你们有多少 专用于 AI 的 数据中心容量已投入运营?
- 你们在数据中心里有多少——按品牌和型号划分的——已投入运营、完成安装并产生收入的 GPU?
- 你们有多少——按品牌和型号划分的——处于库存状态、等待通电或虽已购买但尚未投入运营的 GPU?
英伟达的收入是由需要数年才能变现的资产的投机性销售所驱动的,人人都将对 GPU 的需求与对 AI 算力的需求混为一谈
我知道我是个「泡沫唱衰者」,每个人都因为我唱衰我们庞大而美好的 AI 泡沫而对我感到恼火,但我无法形容目前的情况已经变得多么严重。数千亿美元的债务已经发行,所有能想象到的消费电子产品的价格都被推高,我们股市的大部分以及部分经济都已经依赖于 GPU 的销售,而这些芯片大部分流向了少数几家公司,而它们在很大程度上 根本他妈的没在使用这些芯片。
整件事中还带有一种深刻的悲哀。
耗费了如此多的资金来制造和购买需要数年时间才能建成的 AI 容量芯片,而整个 AI 行业却告诉我们 当下 存在 永不满足的需求,甚至认为我们 去质疑它就是愚蠢的。
人们相信 AI 不是泡沫的核心原因之一是英伟达每个季度持续不断的收入增长,而这再次被冠以 对 AI 算力永不满足的需求 之名,但它实际上 几乎完全是基于对潜在收入的预期而进行的投机性采购,而这一潜在空间 主要由 OpenAI 和 Anthropic 这两家无法盈利且不可持续的 AI 实验室的算力支出所支撑。
这也是黄仁勋不断将数百亿美元输送进循环融资的原因之一——因为 对 GPU 不断扩大的需求幻觉 已经成为 对 AI 算力不断扩大的需求 的替代指标,尽管 前者需要数年时间才能转化为后者,如果真能转化的话。
英伟达目前已经售出了价值至少 2000 亿美元的 GPU——相当于数吉瓦的规模——这些芯片尚未被市场真正消化;而超大规模厂商通过掩盖其实际运营容量并拒绝披露 AI 收入,助长了历史上最大的投机性资产泡沫之一的形成。
每一个参与这种粉饰的人,都对即将发生的一切负有责任。
规划中的容量达到 190 吉瓦,每年需要大约 1.62 万亿至 2.92 万亿美元的需求支撑……而这还是在它们真能建成的假设之下
正如我几个月前估算的,Sightline Climate 的数据显示我们有超过 190 吉瓦的规划数据中心容量,按 1.3 的 PUE(电能使用效率)和每兆瓦 1200 万美元计算,每年需要约 1.62 万亿美元的算力需求才能将其填满。
目前,我估计在 Anthropic 和 OpenAI 之外,大约只有 220 亿美元的需求。
换句话说,我认为我们目前处于不可避免的产能过剩局面中,不会出现类似互联网泡沫破裂后那样干净利落的收场。对英伟达 GPU(以及博通、AMD 等半导体公司的芯片)的需求,是由坚信 AI 产业规模将比今天庞大数倍的投机资本所推动的,而这在很大程度上是因为所有人都误以为对算力容量的需求远比实际情况要大得多。
每一个为 Anthropic 计划到 2026 年底拥有 5 吉瓦容量(纯属虚构)而欢呼雀跃的人都应该清醒地认识到,这家公司正在引发资本主义历史上最大规模的资本错配之一。根本没有 5 吉瓦的容量供 Anthropic 采购,2027 年也不会有额外的 10 吉瓦供其购买,做出这种暗示只会进一步助长关于算力上线速度以及 Anthropic 支付能力的虚妄神话。
英伟达制造了一个由媒体推波助澜的惊人假象——即 GPU 销售额是对 AI 算力真实需求的直接度量,而不是少数几家公司愿意提前两年为某个设想进行投资的度量,它们利用循环融资来制造一种「你现在必须购买这些 GPU,否则就会错失未来」的紧迫感。
容量最终会以 AI 算力市场根本无法承载的规模上线,而当人们看清这一点时,一切都为时已晚。我担心目前关于现有和未来数据中心建设以及 AI 算力需求的每一个模型都是错误的,我们对 AI 底层经济学的所有假设都被「实际运营容量远高于真实水平」这一错误信念所扭曲。
如果我们相信每年有数吉瓦的 AI 算力上线,我们就会随之相信存在数吉瓦的需求。
但如果每年实际上线的只有 一两吉瓦,那完全就是另一回事了。
退一步讲,无论这些容量能否转化为收入,超大规模厂商在未来数年都将背负残酷的折旧费用或沉重的资产减记负担。CoreWeave、Nscale、Lambda 以及所有其他新型云服务商都正行驶在通往深渊的高速公路上,其不断膨胀的债务只能通过依赖少数几家 AI 实验室的合同来偿还,而其中的大客户甚至反复无常到为了元宇宙而改名、烧掉 770 亿美元之后仅过两年就将其废弃。
我甚至不知道该如何表达我的想法而不显得危言耸听……但我看不出英伟达 90% 以上的销售额最终如何能产生哪怕一美元的收入;考虑到依赖项目融资的底层数据中心债务交易规模,如果 AI 算力需求从未兑现,根本没有任何机制能够保护投资者。我不知道该如何避免出现数百亿美元的资产减记和彻底暴雷的数据中心债务交易(牵涉其中的每位投资者都将血本无归),我也不知道大型科技公司如何能免于承认它们浪费了所有的资本支出。
我认为投资于这些领域的每一个人最终都会蒙受损失,从超大规模厂商遭遇尴尬局面和惨淡财报,到任何轻信「所有有用的算力都会被使用」这种陈词滥调的人遭遇真正的毁灭性打击。在那一刻到来之前,越来越多的资金将被投入到更多理论上的容量中,从而使最终的崩盘变得更加惨烈。
归根结底,这一切究竟是为了什么?这达成了什么目标?背负数千亿美元的债务去提前数年购买价值数千亿美元的 AI 芯片,意义何在?
你认为当第一家超大规模厂商撤资时会发生什么?
当债务停止流入时会发生什么?
我给你一个答案:所有人都会意识到,他们把出色的销售说辞误当成了一个蓬勃发展的行业,金融市场和整体经济都将因此承受苦果。
这一切从头到尾都与 AI 无关,每一个误以为真并为黄仁勋的崛起喝彩的人,不过都是被蒙骗的受害者。
真是天大的浪费。我并不喜欢挖掘出这些真相。我真希望我们在多年前就停止这种疯狂。
虽然我不认为我们会停手……但即使他们对 Anthropic 施以援手,即使他们救助了 OpenAI,也绝不可能凭空变出数万亿美元来证明这些资本支出的合理性,或长期支撑超大规模厂商的增长。
这种情况持续得越久,许下的承诺越多,宣布的项目越庞大……最终的结局就会越凄惨。